12 мин.
Spec Kit и OpenSpec в реальном Android-проекте: тестируем SDD на задачах RuStore
Содержание
Команда Android-разработки RuStore активно использует ИИ-инструменты в ежедневной работе. У нас есть ИИ-ревьюер, AI Launcher для настройки агентов, подключения ИИ-моделей и доставки MCP и скиллов, а также автономный агент, который выполняет задачи из трекера. Этот набор мы развивали постепенно — под задачи команды, особенности проекта и существующую инфраструктуру.
Скиллы в этом контуре задают агентам последовательность работы: получить задачу и собрать контекст, провести анализ, написать код с учётом конвенций проекта и проверить результат перед ревью.
Параллельно сообщество развивало подход Spec-Driven Development (SDD), в котором спецификация становится основой для планирования, реализации и проверки изменений. В таких инструментах, как Spec Kit и OpenSpec, спецификации также накапливаются и актуализируются по мере развития проекта.
Мы решили проверить, могут ли они заменить или улучшить наш текущий подход. Для этого встроили оба инструмента в существующий Android-проект RuStore и прогнали их на реальных задачах.
В статье разберём, с какими ограничениями столкнулись при интеграции, как Spec Kit и OpenSpec показали себя в работе и что получилось по стоимости, расходу токенов и качеству результата.
Что такое SDD и чем отличаются Spec Kit и OpenSpec
Spec-Driven Development (SDD) — подход, в котором работа над изменением начинается со спецификации: она фиксирует требования и становится основой для дальнейшего планирования, реализации и проверки результата.
Оба фреймворка сочетают набор скиллов для ИИ-агентов и CLI. Скиллы определяют действия агента на каждом этапе работы, а CLI используется для их установки и настройки, а также для управления возможностями фреймворка. При этом сами процессы в Spec Kit и OpenSpec устроены по-разному.
Spec Kit
Spec Kit хранит спецификации отдельных фич в директориях вида specs/NNN-name/. По мере развития проекта они накапливаются и вместе формируют спецификацию проекта. При этом отдельного механизма, который объединяет изменения в одну актуальную спеку, нет: при изменениях старые спецификации нужно поддерживать вручную и учитывать связи между ними.
Кроме того, в Spec Kit есть constitution. На этапе analyze инструмент проверяет согласованность созданных артефактов между собой и с constitution.
Полный процесс выглядит так:
specify → clarify → plan → tasks → analyze → implement → converge
Если оставить только основные этапы:
specify → plan → tasks → implement
В Spec Kit также есть собственный workflow-механизм, который позволяет последовательно запускать этапы и осуществлять между ними проверки.
OpenSpec
OpenSpec тоже накапливает спецификацию проекта, но иначе организует работу с изменениями. Каждая задача сначала оформляется как отдельный change, а после завершения работы команда archive объединяет его с основной спецификацией.
Проектные правила можно задавать через openspec/config.yaml: содержимое файла добавляется в контекст агента при генерации артефактов. При этом отдельного этапа проверки спецификации на соответствие этим правилам, аналогичного analyze в Spec Kit, нет.
Полный процесс:
explore → propose → apply → verify → archive
При этом explore — необязательный этап, поэтому минимальная цепочка выглядит так:
propose → apply → archive
В отличие от Spec Kit, у OpenSpec нет собственного workflow-движка: он работает со статусами процесса, но не управляет последовательным запуском этапов.
Главное различие
Оба инструмента предполагают накопление спецификаций по мере развития проекта, но организуют этот процесс по-разному:
- Spec Kit накапливает спецификации отдельных фич в specs/NNN-name/, а их согласованность приходится поддерживать по мере изменений;
- OpenSpec оформляет изменения как change и затем через archive объединяет их с основной спецификацией проекта.
В существующем проекте с уже сложившимися процессами, документацией и инфраструктурой интеграция оказывается сложнее. Это мы и проверили на проекте RuStore.
Как устроен наш текущий процесс
Android-проект RuStore — крупный монорепозиторий почти с 800 Gradle-модулями. В нём находятся сборки мобильной и ТВ-версий, публикуемые SDK-артефакты и демо-приложения — например, для просмотра компонентов дизайн-системы и проверки интеграции с SDK.
Для работы с ИИ-инструментами мы используем собственный AI Launcher. Он отвечает за подключение моделей, настройку агентов и доставку MCP и скиллов. Скиллы хранятся отдельно от репозитория, обновляются централизованно, а их набор зависит от проекта и бизнес-юнита.
В ежедневной разработке используются две основные цепочки:
- для эпиков — анализ требований и декомпозиция на задачи;
- для отдельных задач — анализ, написание кода, самопроверка и подготовка к ревью.
Каждый скилл представляет собой Markdown-промпт, в котором явно описано, что агент должен сделать и какие действия выполнять не должен.
Кроме того, у нас работает автономный конвейер. Он поднимает изолированное окружение, получает код из репозитория, запускает агентов для планирования, реализации и ревью, создаёт merge request и передаёт статусы обратно в трекер. Человек подключается уже на этапе ревью MR.
За неполный август конвейер подготовил 41 MR. Около 8–10% из них потребовали ручной доработки, а в среднем каждый MR проходил одну итерацию ревью с возвратом задачи агенту.
Что хотели проверить
Мы хотели понять, смогут ли Spec Kit и OpenSpec улучшить уже работающий процесс или заменить часть нашей собственной инфраструктуры.
Для этого выделили три критерия:
- Интеграция в существующий процесс. Инструмент должен работать с задачами из трекера и не требовать серьёзной перестройки текущего контура.
- Стоимость. Стоимость выполнения типовых задач не должна вырасти в несколько раз по сравнению с нашим текущим подходом.
- Автономность. Инструмент должен как минимум не ухудшать автономную работу конвейера, а в идеале — сокращать количество ситуаций, в которых требуется вмешательство разработчика.
С какими проблемами столкнулись при интеграции
На момент тестирования мы использовали Spec Kit 0.16.0 и OpenSpec 1.9.0.
Оба инструмента проще встроить в новый проект, где процессы и структура документации ещё не сформированы. В нашем случае проект уже существовал: в нём сложились свои процессы разработки и документация, использовался собственный набор ИИ-инструментов. Поэтому сначала нужно было понять, как каждый из фреймворков предлагает работать в таком контексте.
У Spec Kit есть community extensions — расширения сообщества для разных, в том числе специфичных, процессов. Для существующих проектов, например, есть spec-kit-brownfield, который помогает сформировать constitution и сгенерировать спецификации для существующих фич. Однако для нашего проекта полноценная миграция таким способом потребовала бы сгенерировать большой объём спецификаций, а затем проверить и доработать их вручную.
OpenSpec предлагает другой подход: для существующего проекта авторы не рекомендуют отдельно мигрировать всю текущую функциональность. Вместо этого можно начать описывать через спецификации новые изменения и постепенно формировать единую спецификацию проекта по мере работы.
Для теста мы не стали предварительно описывать все существующие фичи ни в одном из инструментов. Чтобы сравнение было сопоставимым, перенесли необходимый контекст из нашей документации в constitution Spec Kit и конфигурацию OpenSpec.
Проблема 1. Работа с задачами из трекера
И Spec Kit, и OpenSpec по умолчанию начинают работу с текстового описания задачи. Наш процесс устроен иначе: агент получает задачу из трекера вместе с эпиком, комментариями и связанными материалами и только после этого приступает к анализу. Поэтому для корректного сравнения нам нужно было научить оба инструмента самостоятельно получать этот контекст.
В Spec Kit для кастомизации можно использовать extensions и presets. Extension позволяет выполнять дополнительные действия до или после стандартных команд, однако этого оказалось недостаточно: команда specify всё равно ожидает на вход текст требований. Поэтому мы создали собственный preset и заменили стандартный specify, чтобы вместо описания фичи он принимал идентификатор задачи и получал требования из трекера через наш MCP.
Такой подход работает, но создаёт дополнительную зависимость от внутренней реализации Spec Kit: при полной замене команды приходится сохранять обязательную служебную логику оригинального шаблона — например, создание feature.json, правила именования директорий и поддержку хуков.
В OpenSpec аналогичную задачу решили через schema fork. Команда создаёт копию схемы workflow и шаблонов, которые можно изменить под свой процесс. В нашей версии propose сначала обращается в трекер и собирает необходимую информацию о задаче.
В результате оба инструмента удалось встроить в наш сценарий, но для этого потребовалась кастомизация их стандартного процесса.
Проблема 2. Поддержка кастомизаций
После интеграции у нас появились собственный preset для Spec Kit и кастомная schema для OpenSpec. Следующий вопрос — как поддерживать их версии и доставлять изменения разработчикам.
В OpenSpec схема хранится прямо в репозитории и обновляется вместе с кодом. Это удобно, но создаёт риск несовместимости: если часть команды обновит OpenSpec раньше остальных, новая версия схемы может не работать со старой версией CLI.
В Spec Kit preset можно вынести в отдельный каталог и раздавать независимо от репозитория. Но проблема остаётся похожей: после обновления самого Spec Kit кастомизированные команды могут оказаться несовместимы с новой версией. Дополнительно потребуется поддерживать инфраструктуру для хранения и доставки preset.
Для нас это особенно важно, потому что такая инфраструктура уже есть. AI Launcher централизованно доставляет разработчикам актуальные версии скиллов. Поэтому переход на хранение кастомизаций в монорепозитории или создание отдельного механизма доставки не даёт очевидного преимущества, но добавляет ещё один слой поддержки.
Проблема 3. Источник истины
В существующем проекте уже есть свои процессы, документация и описания фич. При внедрении SDD появляется ещё один источник информации — спецификации внутри репозитория.
В OpenSpec изменения сначала оформляются как change, а после завершения работы объединяются с основной спецификацией через archive. В Spec Kit спецификации отдельных фич сохраняются в репозитории и со временем накапливаются.
Для нового проекта такой процесс можно выстроить с самого начала. В уже работающем проекте приходится заранее определять, какой источник считать основным и как синхронизировать спецификации с уже существующей документацией.
В случае OpenSpec дополнительно нужно определить процесс archive: кто и на каком этапе его запускает, входит ли обновление спецификации в merge request и как контролировать, что изменения действительно были архивированы.
Есть и технический нюанс: до выполнения archive пересекающиеся изменения могут оставаться незаметными друг для друга, что усложняет параллельную работу со спецификацией. В репозитории OpenSpec опубликован план с рекомендациями по работе в таких сценариях, поскольку встроенного механизма разрешения этой проблемы пока нет.
В результате само накопление спецификаций требует отдельного процесса поддержки. Для нашего проекта его пришлось бы встраивать в уже существующую систему документации и разработки, а ценность такой перестройки на этом этапе была неочевидна.
Проверка на реальных задачах
После настройки мы прогнали Spec Kit, OpenSpec и нашу цепочку на двух задачах разного масштаба:
- исправление падающего юнит-теста;
- разработка data-слоя новой фичи в отдельном Gradle-модуле.
Все прогоны выполняли на Opus 5, статистику собирали командой usage. Для первой задачи сравнивали только этап анализа, для второй — полный цикл до реализации.
Использовали следующие цепочки:
- Spec Kit: specify → clarify → plan → tasks → implement;
- OpenSpec: propose → apply;
- наша цепочка — стандартный процесс анализа и реализации через собственные скиллы.
Полные цепочки сознательно не запускали. В OpenSpec пропустили explore, поскольку требования уже были зафиксированы в задаче, а archive не включали в тест: на этом этапе мы ещё не определяли, как встроить архивацию в наш процесс, и сравнивать этот шаг с текущей цепочкой было не с чем.
В Spec Kit не использовали analyze — для этих задач дополнительная проверка согласованности артефактов была избыточной. Converge, как и archive, выполняется после реализации, поэтому в первой задаче до этого этапа не доходили.
Для каждой задачи сделали по одному прогону. Целью было не получить статистически точный бенчмарк, а сравнить порядок затрат и посмотреть, как инструменты ведут себя на одинаковых вводных.
Проверка 1. Исправление падающего теста
Первая задача — исправить юнит-тест для класса, который работает с файлами. Тест падал в CI-окружении, а само изменение затрагивало два тестовых метода.
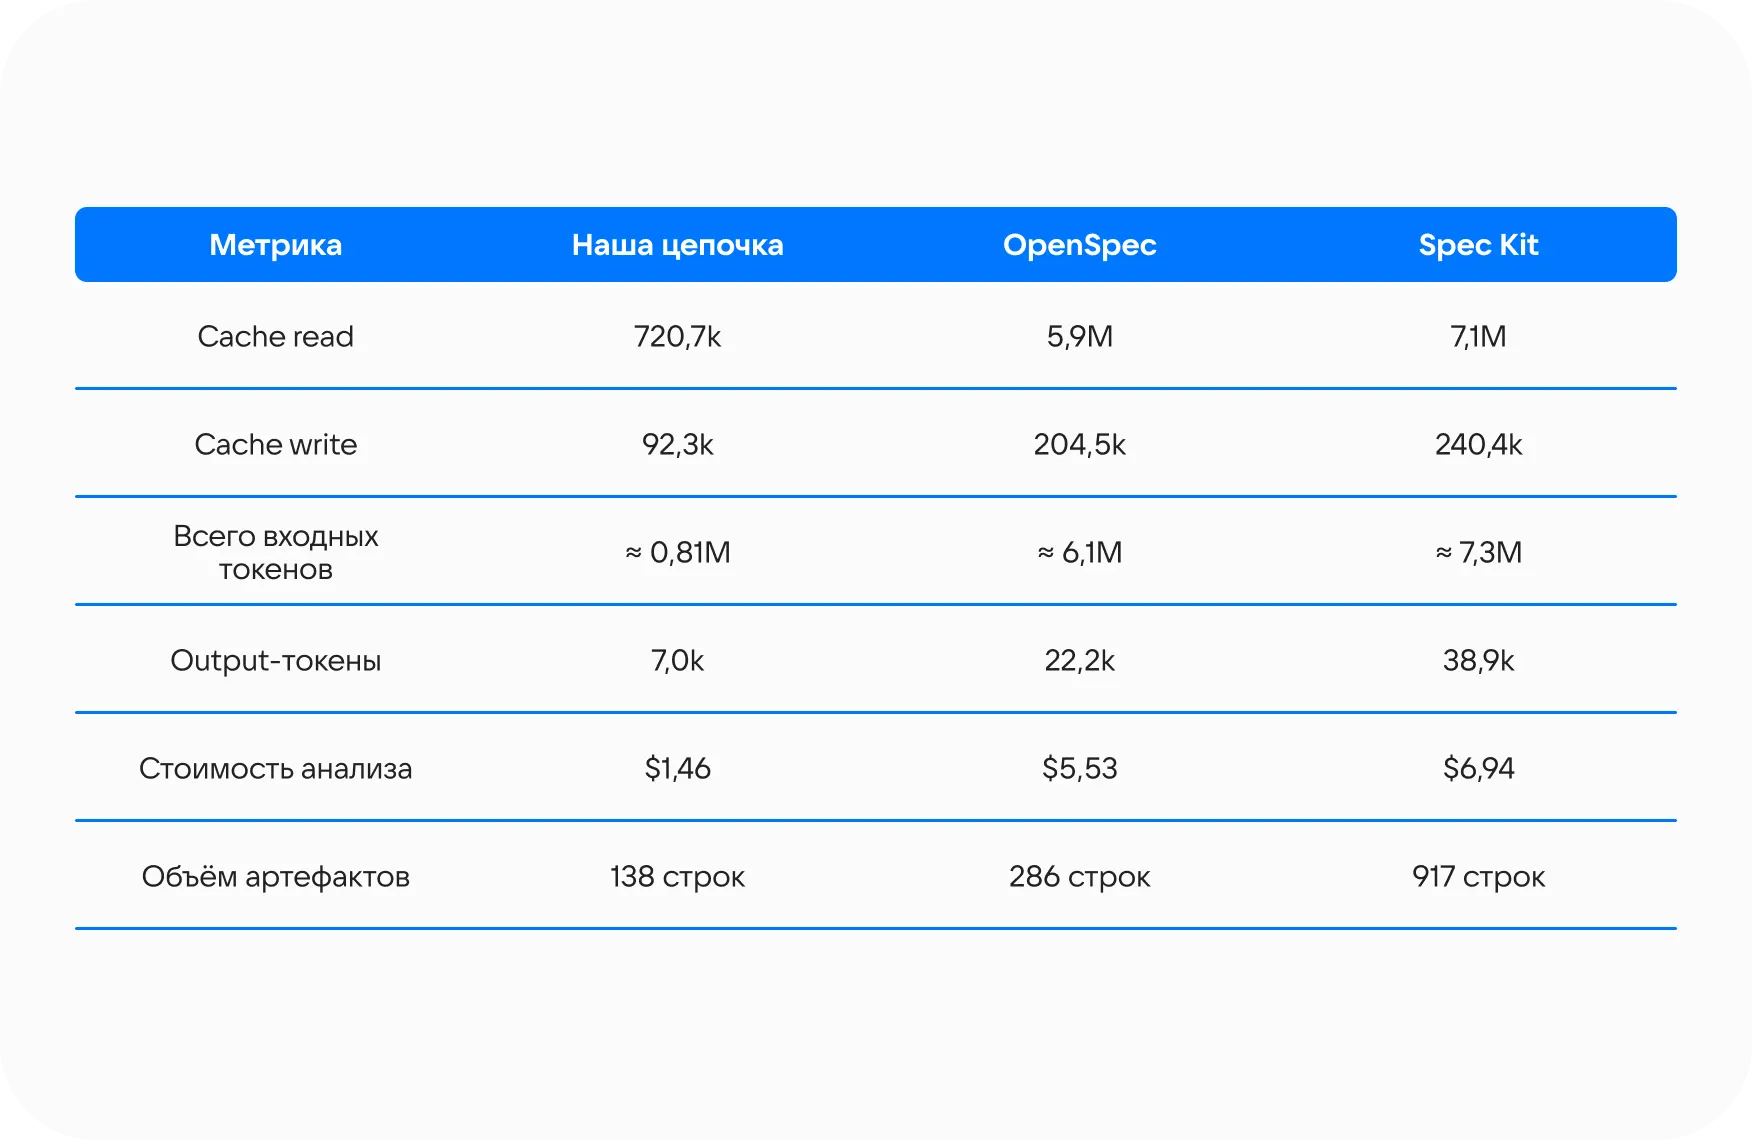
Оба SDD-фреймворка использовали заметно больше входных токенов и генерировали более объёмные артефакты. Основной рост пришёлся на cache read. Похоже, каждый следующий этап заново обращался к уже созданным артефактам.
При этом сама задача содержала важный нюанс: решение, предложенное в постановке, исправляло один тест, но ломало другой. Все три подхода обнаружили эту проблему, однако проверяли гипотезу по-разному.
Наша цепочка зафиксировала, что решение «проверено экспериментально», но из результата не было понятно, какая именно проверка выполнялась.
Spec Kit создал черновой вариант исправления, проверил его, отбросил нерабочий вариант и выбрал проверенный.
OpenSpec пошёл ещё дальше: нашёл доступный Docker и запустил тестовый пример в подходящем окружении.
Это стало одним из полезных результатов эксперимента. Более строгую проверку гипотез на этапе анализа мы решили перенести и в собственные скиллы — в частности, требовать от агента явно фиксировать, как именно был проверен выбранный вариант.
Проверка 2. Новый модуль с нуля
Вторая задача была заметно сложнее: нужно было реализовать доменный и data-слой новой фичи в отдельном Gradle-модуле с разделением на api и impl, ручным DI, фича-тогглом и локальным хранилищем.
Дополнительно нужно было определить, требуется ли аналогичный модуль для ТВ-версии приложения, где сама фича не используется, но могла появиться техническая зависимость от нового кода.
На этот раз мы прогнали все три подхода от анализа до реализации.
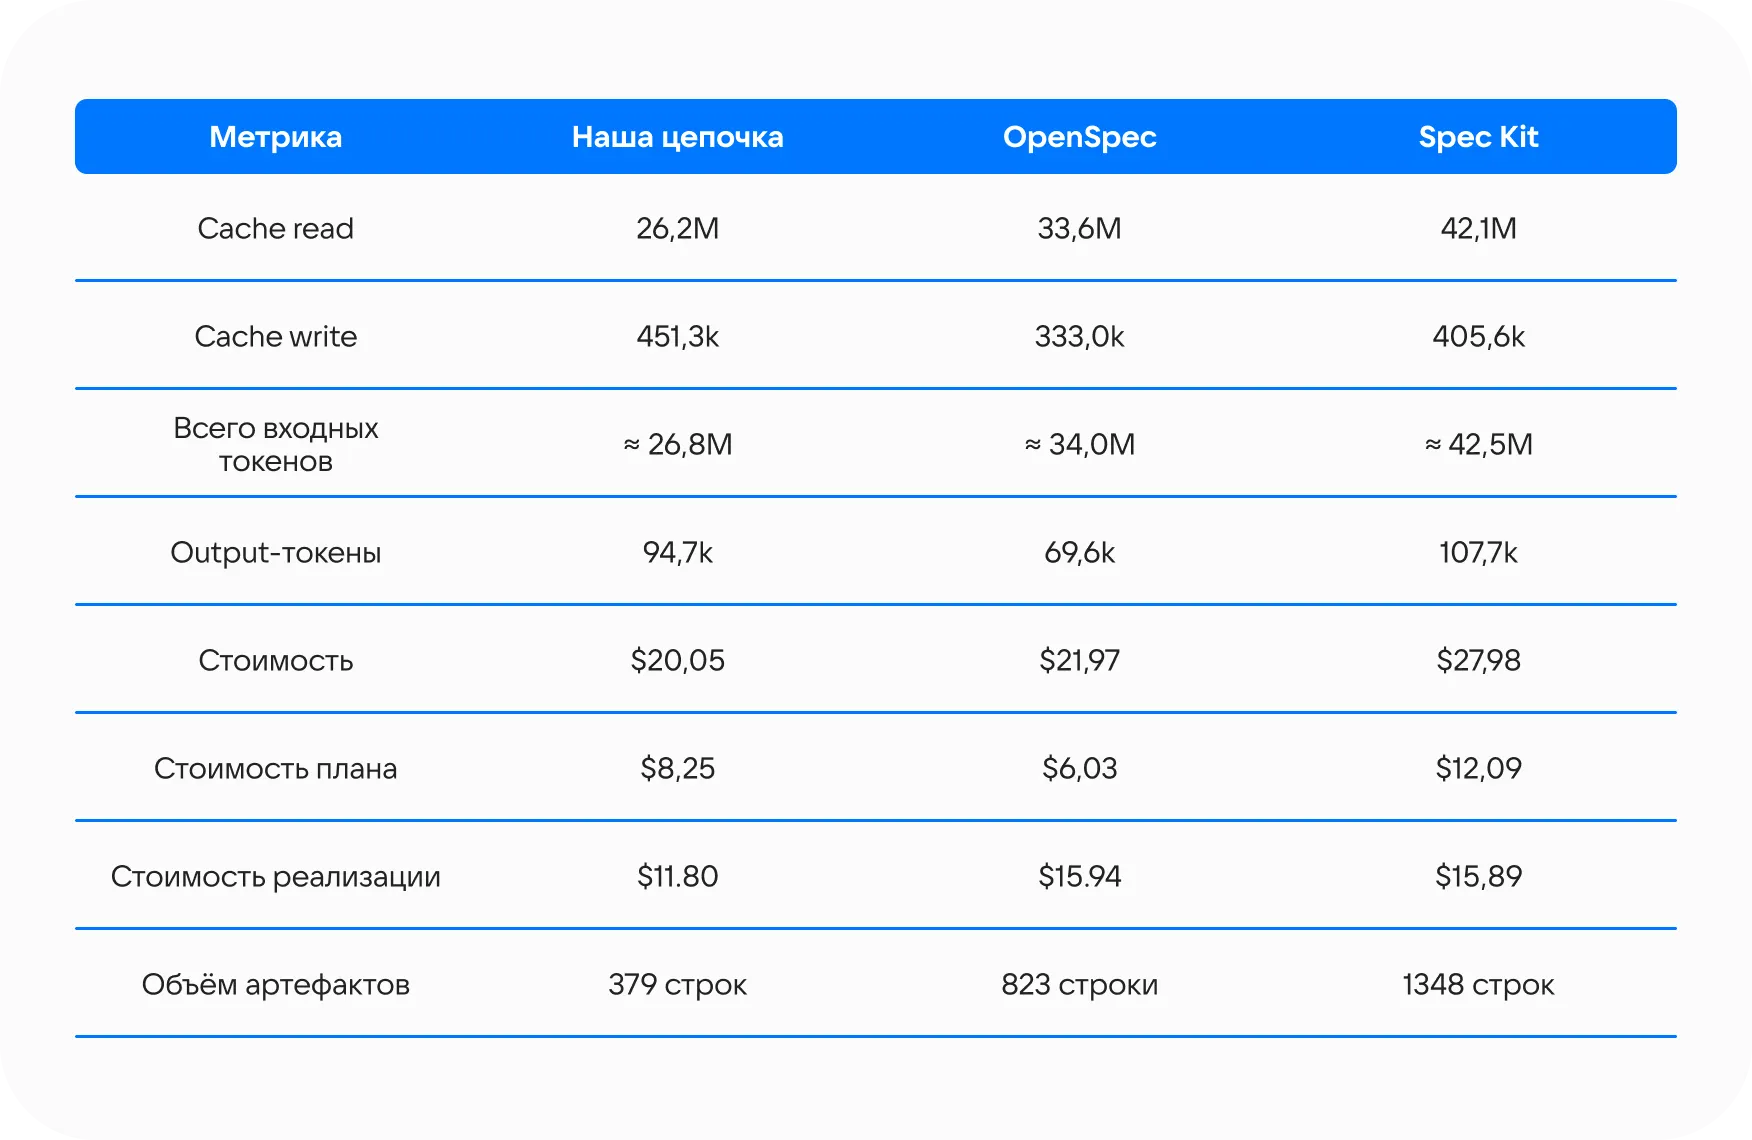
На более крупной задаче разница в общей стоимости оказалась меньше, чем в первом тесте. При этом Spec Kit снова потребовал больше всего входных токенов и создал самый большой объём артефактов.
В процессе выполнения наша цепочка дополнительно подтянула актуальную ветку develop. Там уже изменился механизм работы с фича-тогглами, поэтому часть первоначального плана пришлось пересобрать по ходу реализации. Агент адаптировался к изменениям, а итоговая стоимость всё равно осталась ниже, чем у обоих SDD-фреймворков.
Задача содержала ещё один важный нюанс. В постановке предлагалось сохранять данные в общие SharedPreferences, хотя этот подход в проекте уже был помечен как deprecated. В качестве примера был указан соседний модуль, где аналогичная реализация всё ещё проходила проверки благодаря исключению в baseline статического анализатора.
На этой задаче инструменты обнаружили проблему на разных этапах:
- в Spec Kit для уточняющих вопросов предусмотрен отдельный этап clarify, но проблема с deprecated-подходом обнаружилась только на implement;
- OpenSpec не задал уточняющих вопросов на propose, проблема проявилась уже на apply;
- наша цепочка обнаружила несоответствие и задала вопрос ещё на этапе анализа.
Отдельно мы проверяли решение по ТВ-версии. В постановке требовалось определить, нужен ли новый модуль в ТВ-приложении. Оба SDD-фреймворка не отработали это требование до конца и добавили в ТВ-сборку два новых модуля и четыре DI-класса, хотя сама фича там не используется.
У OpenSpec появились и дополнительные изменения, которых не было в требованиях: метод записи в публичном контракте и константа для диплинка. Вместе с ними в модуль попала лишняя зависимость.
На этой задаче SDD-фреймворки не дали преимущества в автономности: ключевые вопросы возникли уже во время реализации, а часть требований осталась неотработанной. При этом наша цепочка выявила критичные неоднозначности раньше — ещё на этапе анализа.
Выводы
В наших тестах Spec Kit и OpenSpec показали полезные механики, но с учётом текущих процессов разработки их преимущества не компенсировали затраты на интеграцию и поддержку.
Что оказалось полезным
Оба фреймворка лучше нашей текущей цепочки проверяли гипотезы на этапе анализа. В первой задаче Spec Kit и OpenSpec не ограничились формальным выводом, а фактически проверили предложенное решение.
Этот подход мы решили перенести в собственные скиллы: будем требовать от агента не только выбрать вариант, но и явно фиксировать, как именно он его проверил.
Что нам не подошло
1. Дополнительная инфраструктура и поддержка
Для интеграции пришлось кастомизировать стандартные процессы обоих инструментов. В случае OpenSpec это означает поддержку собственной schema, в случае Spec Kit — preset. При обновлении CLI такие кастомизации могут потребовать отдельной проверки и доработки.
При этом у нас уже есть AI Launcher, который централизованно доставляет разработчикам актуальные версии скиллов и настроек.
2. Поддержка спецификаций
Оба подхода предполагают накопление спецификаций внутри репозитория. В существующем проекте это создаёт дополнительный источник информации, который нужно синхронизировать с уже работающими процессами и документацией.
Для OpenSpec также необходимо выстраивать отдельный процесс archive, а для Spec Kit — следить за актуальностью спецификаций отдельных фич.
3. Стоимость
В обоих тестах SDD-фреймворки использовали больше входных токенов и создавали более объёмные артефакты.
На небольшой задаче разница в стоимости была особенно заметной. На более крупной она сократилась, но наша цепочка всё равно оказалась дешевле обоих вариантов.
4. Автономность
На второй задаче оба фреймворка потребовали вмешательства разработчика уже во время реализации. Часть требований при этом осталась неотработанной, в частности, решение по ТВ-сборке.
Для нашего автономного конвейера это критично: вопросы, которые возникают после начала реализации, прерывают автономный прогон.
Поэтому использовать Spec Kit или OpenSpec как основу текущего автономного процесса мы пока не планируем.
Когда эти инструменты могут быть полезны
Наш результат не означает, что Spec Kit и OpenSpec не подходят для других сценариев.
В первую очередь они могут быть удобны для:
- новых проектов, где процесс можно сразу выстроить вокруг спецификаций;
- унификации инструментов между командами — например, через presets Spec Kit;
- процессов со специфическими требованиями, для которых подходят готовые extensions Spec Kit.
В нашем случае собственная система уже глубоко встроена в процессы команды. Чтобы адаптировать SDD-фреймворки под те же требования, пришлось бы фактически воспроизвести значительную часть механизмов, которые у нас уже есть. Поэтому вместо миграции мы забрали отдельные полезные практики и продолжим развивать текущий подход.
💙 Мы в MAX